deepspeed 详解-源码分析
大模型火了之后,大模型的分布式训练自然而然成为了一个研究热点,其中 deepspeed 无疑是
最火爆的开源分布式训练框架之一。最近失业了,比较闲,正好整理一下 deepspeed 的实现细节,
帮助大家更深入的了解和学习 deepspeed 这个框架。
ps:deepspeed 无疑是非常好用和流行的,但代码写的实在一言难尽。
在开始讲代码细节前,先整理一下大模型分布式训练的关键逻辑和问题,这样更容易理解一些技术点到底是为什么。 很多博客上来就是 “大模型的训练有三种并行策略,分别是数据并行、流水线并行和张量并行”, 和国内的教材一个风格,显然这对于新手小白不是很友好, 这里我们先讲为什么,再说有什么。
单卡时代
Long long ago,一个深度学习模型并没有超过单个显卡的显存,其全部模型参数都可以加载到一个GPU中, 并且在单卡完成整个训练或者推理过程。这个时代,大家都能很愉快的玩耍。
多卡并行时代
后来随着显卡越来越便宜,训练数据量越来越多,人们逐渐开始研究如何利用多卡加速模型的训练,实现思路也很常规,
就是多张卡同时参与训练,每张卡都独立加载整个模型,并且独立进行前后向过程。通过把训练数据的一个大的 batch
分成多个小 batch,每张卡独立处理一个小 batch,最后再把各个卡上的梯度汇总整合起来,在一个主卡(主进程)
中计算新的参数值,然后再把新参数同步到各个卡中,这样实现数据的并行训练,所以称之为数据并行(Data Parallel,DP )
。 pytorch 的 Data Parallel (DP) 和 Distributed Data Parallel (DDP) 都是这种方法的实现,
其中 Data Parallel (DP) 早于 Distributed Data Parallel,
Data Parallel (DP) 是 单机多卡 的实现,
Distributed Data Parallel 是 多机多卡 的实现。
大模型时代
进入大模型时代后,一张卡的显存不足以加载完整的模型或者完成一个训练过程,上述的 DP 和 DDP 的方案自然就失效了。
遇到问题就要想办法解决,那如何解决这个问题呢?先不用考虑那些论文,我们自己思考一下。
首先要弄清楚的是,消耗显存的都有哪些?
模型的参数。
前向过程中,一些中间计算结果以及激活值(即激活函数的执行结果)。
后向过程中,每个参数的梯度值。
优化器的状态。比如
adam算法,需要为每个参数再保存一个一阶动量和二阶动量。
接下来,思考如何解决内存不足的问题。核心思路其实很简单,主要有两个方向:
先不把全部数据加载到 GPU 显存,暂时存放在别的地方,需要的时候再同步到 GPU 显存中,用完就扔掉。
把参数放到 CPU 内存中或者高速SSD中(支持NVMe的ssd,走的PCI-E总线),这就是
deepspeed中的offload技术。多张GPU卡,每张卡保存一部分,需要的时候再从其他卡同步过来,这就是参数分割。
降低内存的需求。原来每个参数都是
float32类型,占用4个字节。
改成半精度,用2个字节的
float16替代4个字节float32,显存需求一下就降低一半。用量化技术,用2个字节的
int16或者1个字节的int8代替4字节的float32。
显然,每种方法都不是完美的,都有一定的局限性并且会引入新的问题,比如:
参数进行多卡分割或者
offload,比如会增加大量数据同步通信时间,不要小看这部分时间消耗,相对于 GPU 的显存访问速度而言, 多机器之间的网络通信、单机多卡之间通信、cpu内存到GPU内存的通信,这些都是巨大的延迟。模型运行中,大量的浮点数乘法,产生很多很小的浮点数,降低参数精度,会造成数据溢出,导致出问题,即使不溢出,也损失了数据准确性。 模型训练时,梯度误差大,导致损失不收敛。模型推理时,误差变大,推理效果变差。
参数分割策略
说到分割参数,无论是多GPU之间分割参数,还是 offload 到CPU内存,都需要对参数进行分割分组。
这就涉及到多种划分策略。
按照模型的层(Layer)进行分割,保留每一层(Layer)为整体,不同层存储在不同的
GPU中, 多个层(GPU)串行在一起,需要串行执行,这就是所谓的 流水线并行(Pipeline Parallel,PP)。时间效率很差, 并且如果某一层的参数量就很大并超过了单卡的显存就尴尬。当然可以通过异步执行一定程度解决时间效率差的问题,有兴趣的读者可以研读相关资料。把参数张量切开,切开张量分开存储很容易,但切开之后,张量计算的时候怎么办?这里可以分两种策略。 1. 张量的计算过程也是可以切割,这样把一个大的张量,切分成多个小张量,每张
GPU卡只保存一个小片段,每个小张量片段(GPU卡)独立进行相关计算,最后在需要的时候合并结果就行了。这种思路就称为 张量并行(Tensor Parallel,TP) ,Megatron就是走的这个路线。 2. 同样是把参数张量分割,每张卡只保存一个片段。但是需要计算的时候,每张卡都从其他卡同步其它片段过来,恢复完整的参数张量,再继续数据计算。Deepspeed选取的这个策略,这个策略实现起来更简单一些。
降低精度
降低参数精度也有讲究,有些地方可以降低,有些地方就不能降低,所以一般是混合精度。
半精度还有另一个好处,就是 计算效率更高,两个字节的计算速度自然是高于4个字节的。
在模型训练过程中,参数的梯度是非常重要的,参数更新累积梯度变化时,如果精度损失太多会导致模型不收敛。
所以优化器的状态一般需要保留 float32 类型,具体参看下图。
有关混合精度更细节内容请参考论文 Mixed Precision Training
[1]
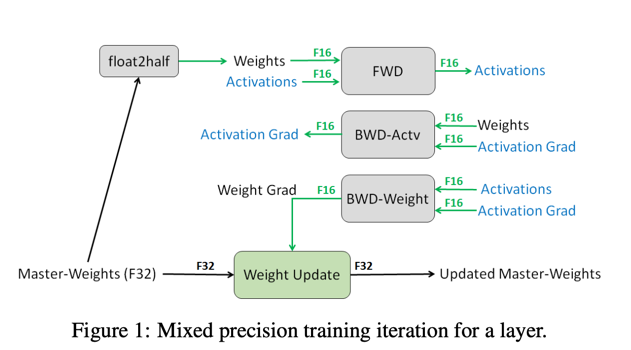
图 3 (图片来自论文 MIXED PRECISION TRAINING )
实际上,GPU 显存不足的问题更多的是靠上面的参数分割来解决,半精度的应用更多的是为了提高计算速度。
流水线并行、张量并行,把模型一次完整的计算过程(前后向)分拆到多个 GPU 上进行,
所以这两者都被称为模型并行(Model Parallel,MP)。
而如果每张卡都能进行模型一次完整前后向计算,只是每张卡处理不同的训练数据批次(batch),
就称为数据并行(Data Parallel,DP)。
deepspeed 对参数进行了分割,每张卡存储一个片段,但在进行运算时,
每张卡都会恢复完整的参数张量,每张卡处理不同的数据批次,
因此 deepspeed 属于数据并行。
最后总结一下, 针对大模型的训练有三种并行策略,理解起来并不复杂:
数据并行:模型的计算过程没有分割,训练数据是分割并行处理的。
- 模型并行:模型的计算过程被分割。
流水线并行:模型按照层(Layer)切分。
张量并行:把参数张量切分,并且将矩阵乘法分解后多 GPU 并行计算。
接下来是 deepspeed 的详解: